
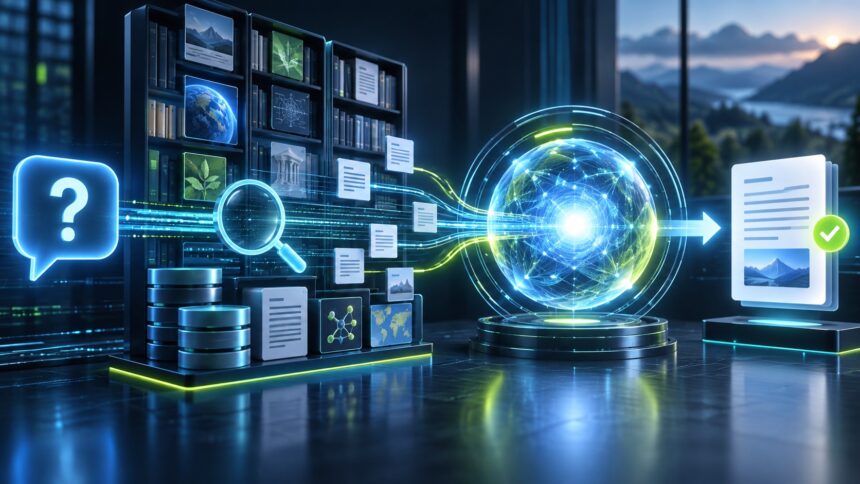
RAG, büyük dil modellerinin yanıt üretmeden önce güvenilir dış kaynaklardan ilgili bilgiyi bulmasını ve yanıtını bu bilgilerle temellendirmesini sağlayan yöntemdir. İngilizce “Retrieval-Augmented Generation” ifadesinin kısaltmasıdır ve Türkçede “erişim destekli üretim” olarak karşılanabilir.
RAG nedir?
Bir LLM yalnızca eğitim sırasında öğrendiği örüntülere dayanırsa güncel veya kuruma özel bilgiyi bilemeyebilir. RAG, kullanıcı sorusuyla ilgili belge parçalarını bir bilgi tabanından getirir ve modele ek bağlam olarak sunar. Model böylece cevabı verilen kanıtlara dayanarak üretir.
RAG nasıl çalışır?
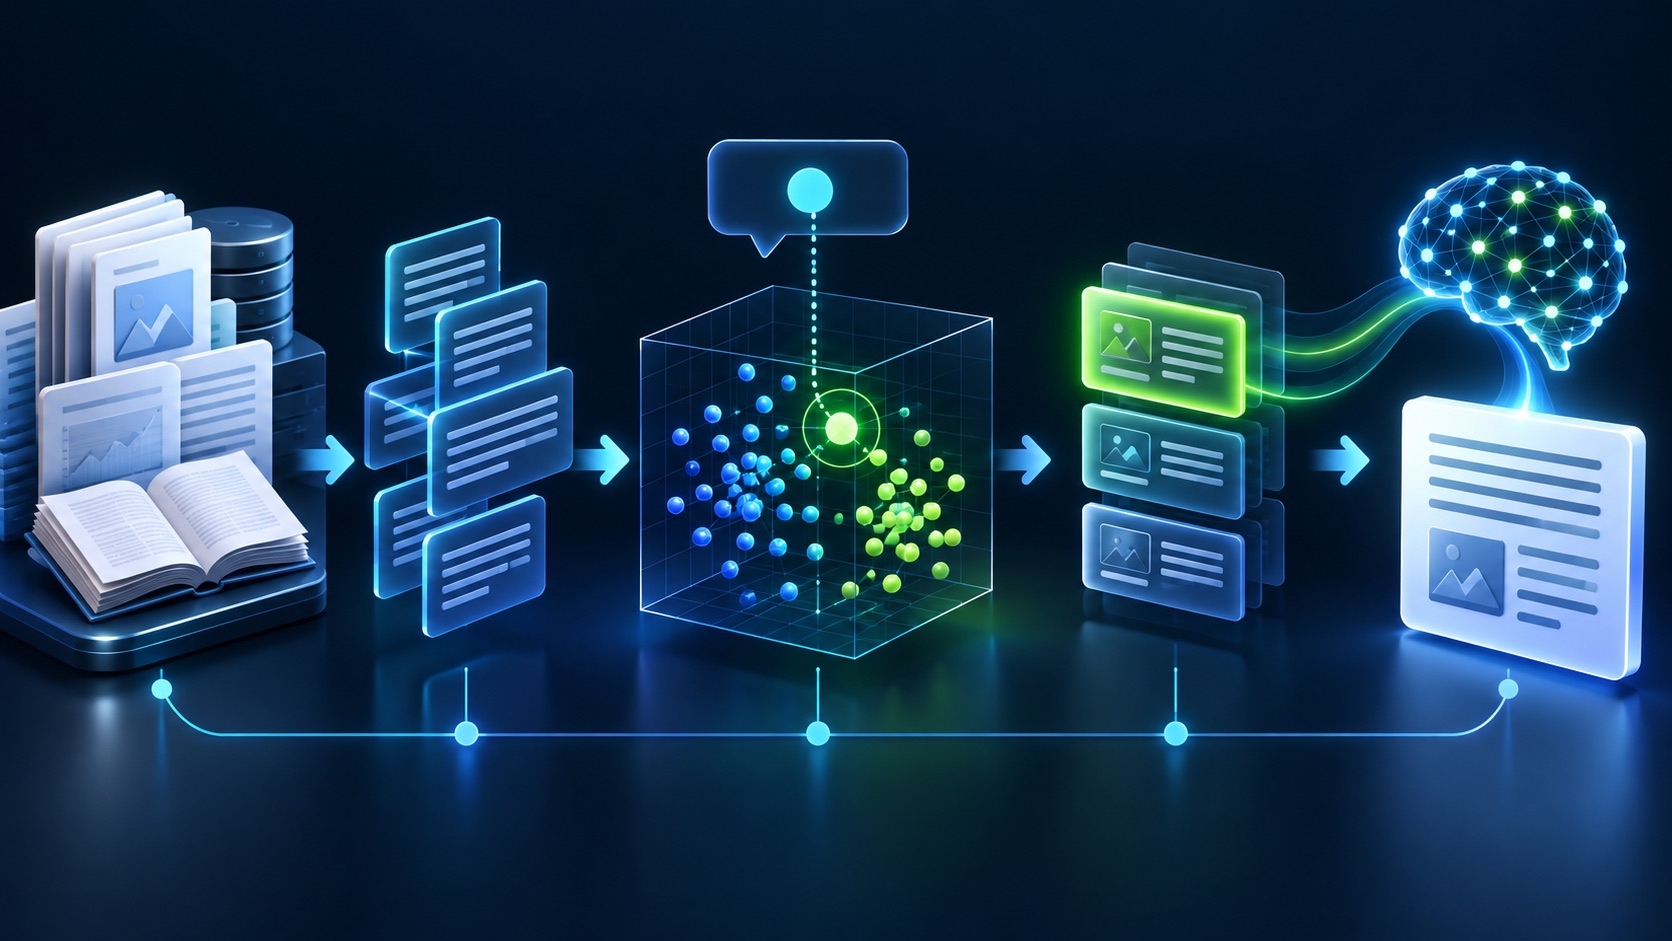
- Kaynak hazırlama: Belgeler toplanır, temizlenir ve yönetilebilir parçalara bölünür.
- Vektörleştirme: Metin parçaları anlam ilişkilerini temsil eden embedding’lere dönüştürülür.
- Arama: Kullanıcının sorusuna en yakın belge parçaları bulunur.
- Bağlam oluşturma: Seçilen kanıtlar, soru ve talimatlarla birlikte modele gönderilir.
- Yanıt üretme: Model, getirilen kaynaklara dayalı cevap oluşturur.
RAG neden kullanılır?
RAG, modelin güncel bilgiye erişmesini, kurum içi belgelerle çalışmasını ve yanıtın dayanağını göstermesini kolaylaştırır. Modeli baştan eğitmeden yeni bilgi eklenebildiği için bakım ve güncelleme açısından da avantajlıdır.
En yaygın kullanım alanları kurumsal bilgi asistanları, destek sistemleri, mevzuat araması, ürün dokümantasyonu, araştırma araçları ve belge tabanlı soru yanıtlamadır.
RAG halüsinasyonu önler mi?
RAG, halüsinasyon riskini azaltabilir fakat tamamen ortadan kaldırmaz. Arama sistemi ilgisiz belge getirebilir, kaynak güncel olmayabilir veya model doğru belgeyi yanlış yorumlayabilir. Bu nedenle kaynak kalitesi, arama başarısı ve yanıt doğrulaması ayrı ayrı ölçülmelidir.
RAG ile ince ayar arasındaki fark nedir?
RAG, bilgiyi çalışma anında dış kaynaktan getirir. Fine-tuning veya ince ayar ise modelin davranışını örneklerle değiştirir. Güncel bilgi, kaynak gösterimi ve sık değişen kurum verileri için RAG; üslup, çıktı biçimi ve belirli görev davranışları için ince ayar daha uygun olabilir. İki yöntem birlikte de kullanılabilir.
RAG sisteminin temel bileşenleri
- Güvenilir ve izinleri yönetilen veri kaynakları
- Belge ayrıştırma ve parçalara ayırma süreci
- Embedding modeli ve vektör veritabanı
- Semantik, anahtar kelime veya hibrit arama
- Sonuçları yeniden sıralayan bir re-ranker
- Yanıt üreten dil modeli ve kaynak gösterimi
- Kalite, güvenlik ve geri bildirim ölçümleri
Belge parçalama ve arama kalitesi neden önemlidir?
Belgeler çok büyük parçalara ayrılırsa gereksiz içerik bağlamı doldurabilir; çok küçük parçalarda ise önemli ilişkiler kopabilir. Başlık, bölüm ve paragraf yapısını dikkate alan parçalama çoğu zaman sabit karakter sayısından daha iyi sonuç verir. Parçaların kaynak, tarih ve yetki bilgileri gibi metadata ile saklanması filtreleme ve kaynak göstermeyi kolaylaştırır.
Semantik arama anlam benzerliğini, anahtar kelime araması ise özel isim ve kesin ifadeleri yakalamada güçlüdür. Hibrit arama iki yaklaşımı birleştirir. Re-ranker, ilk sonuçları soruyla ilişkisine göre yeniden sıralayarak modele daha güçlü kanıtlar gönderilmesini sağlar.
RAG kalitesi nasıl ölçülür?
Değerlendirme yalnızca son cevaba bakmamalıdır. Doğru belgenin bulunup bulunmadığı, getirilen parçaların soruyla ilgisi, yanıtın bu parçalara sadakati, alıntıların doğruluğu ve yeterli kanıt olmadığında sistemin durabilmesi ayrı ölçülmelidir. Gerçek kullanıcı sorularından oluşturulan test setleri zaman içinde tekrar çalıştırılmalıdır.
Başarılı bir RAG sistemi için nelere dikkat edilmeli?
Belgeler güncel tutulmalı, gereksiz tekrarlar temizlenmeli ve erişim izinleri korunmalıdır. Parça boyutu, arama yöntemi ve getirilecek sonuç sayısı gerçek sorularla test edilmelidir. Modelden yalnızca verilen kaynaklara dayanması, yeterli kanıt yoksa bunu açıkça söylemesi ve her önemli iddiayı kaynakla eşleştirmesi istenmelidir.
Kullanıcının sorusu da sonucu etkiler. Açık amaç, zaman aralığı ve beklenen çıktı biçimi içeren iyi bir prompt, doğru belgenin bulunmasına yardımcı olur.
RAG hakkında sık sorulan sorular
RAG için vektör veritabanı şart mı?
Hayır. Küçük sistemlerde klasik arama yeterli olabilir. Vektör arama, anlamsal benzerlik ve ölçek büyüdüğünde avantaj sağlar.
RAG internette arama yapmak mıdır?
İnternet bir kaynak olabilir; ancak RAG çoğunlukla seçilmiş web sayfaları, dosyalar, veri tabanları veya kurum içi bilgi tabanlarıyla çalışır.
RAG veriyi modele öğretir mi?
Hayır. Bilgi genellikle model ağırlıklarına yazılmaz; yanıt anında bağlam olarak sunulur.
Sonuç
RAG, arama ile üretken yapay zekâyı birleştirerek daha güncel, ilgili ve doğrulanabilir yanıtlar oluşturmayı amaçlar. Başarısı modelden çok bütün sistemin; kaynakların, erişimin ve değerlendirme sürecinin kalitesine bağlıdır.