
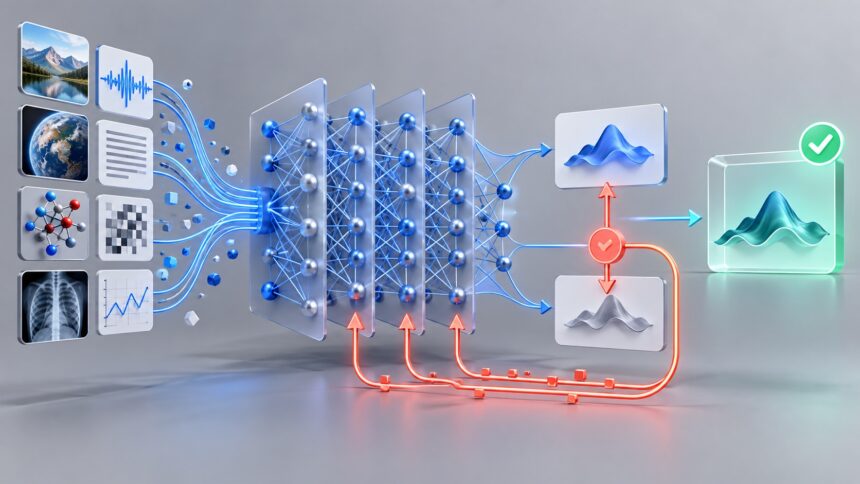
Yapay zekâ modeli eğitimi, bir algoritmanın verilerdeki örüntüleri öğrenerek yeni girdiler üzerinde tahmin veya içerik üretebilir hâle gelmesi sürecidir. Model, başlangıçtaki tahminlerini gerçek sonuçlarla karşılaştırır; hatayı ölçer ve bu hatayı azaltacak biçimde parametrelerini tekrar tekrar günceller.
Yapay zekâ modeli nedir?
Model, veriden öğrenilmiş matematiksel ilişkiler bütünüdür. Geleneksel yazılımda kurallar geliştirici tarafından açıkça yazılır. Makine öğrenmesinde ise sistem, örneklerden hangi ilişkilerin yararlı olduğunu öğrenir. Eğitim tamamlandıktan sonra modelin yeni veriye uyguladığı tahmine “çıkarım” veya inference denir.
Yapay zekâ modeli nasıl eğitilir?
- Problem tanımlanır: Tahmin edilecek sonuç ve başarı ölçütü belirlenir.
- Veri hazırlanır: Veriler toplanır, temizlenir, etiketlenir ve dengelenir.
- Veri bölünür: Eğitim, doğrulama ve test kümeleri birbirinden ayrılır.
- Model seçilir: Göreve uygun algoritma ve mimari belirlenir.
- Eğitim yapılır: Tahmin hatası hesaplanır ve parametreler optimize edilir.
- Değerlendirme yapılır: Model daha önce görmediği verilerle ölçülür.
- Yayınlanır ve izlenir: Gerçek kullanım performansı takip edilir.
Eğitim, doğrulama ve test verisi neden ayrılır?
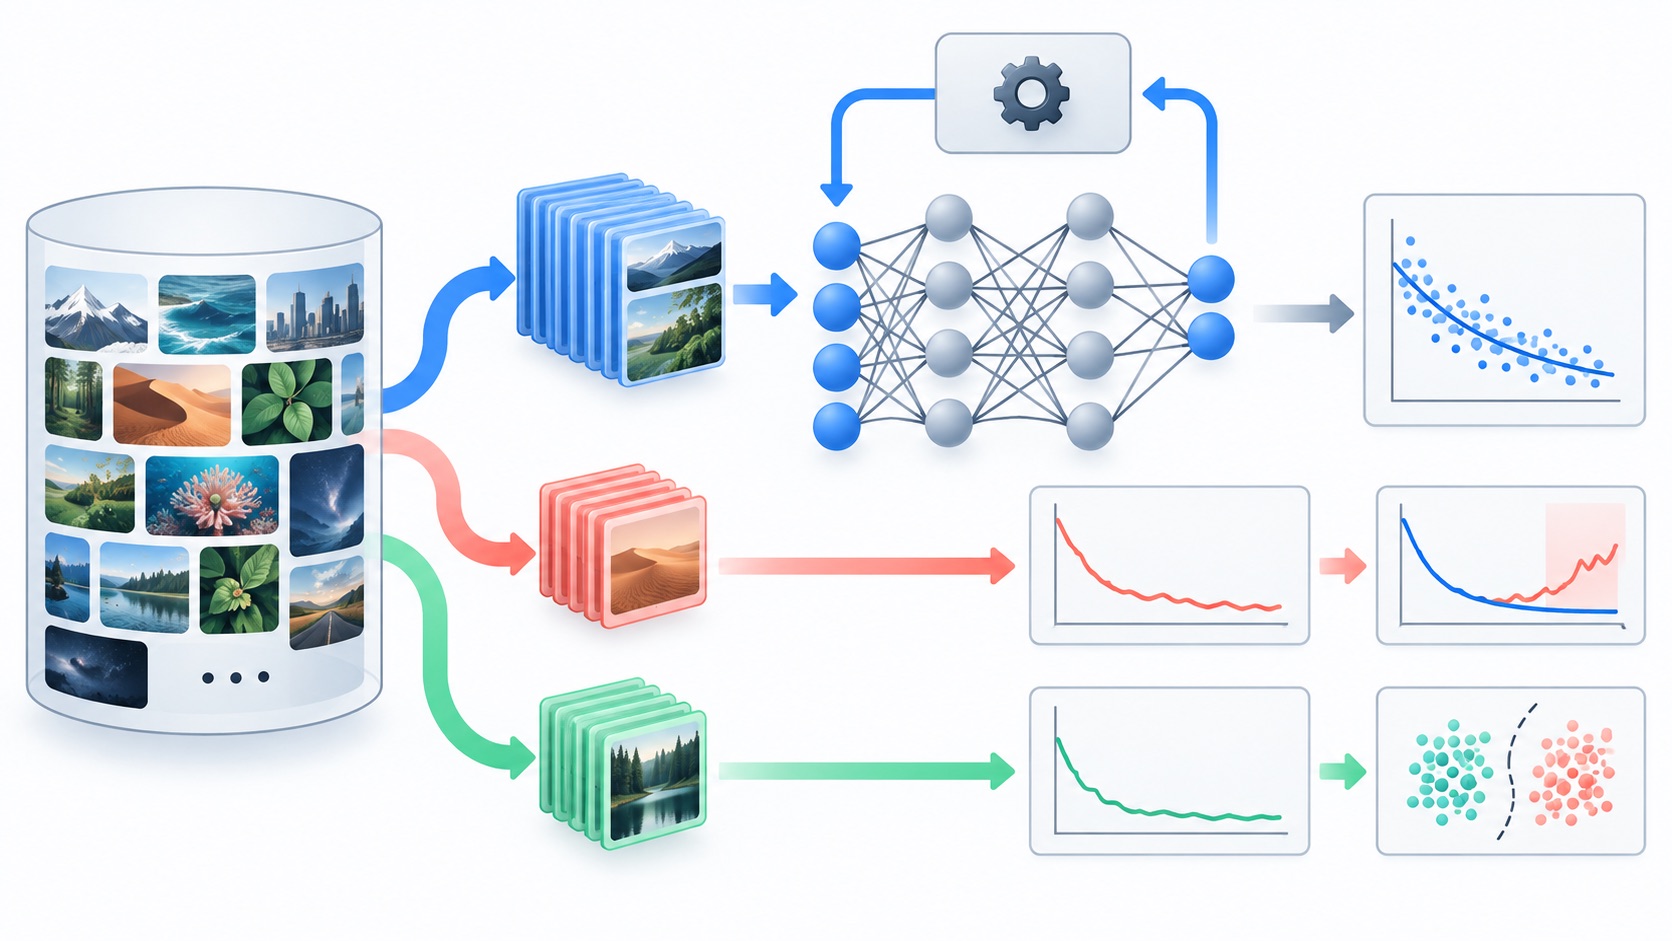
Eğitim verisi model parametrelerini öğrenmek için kullanılır. Doğrulama verisi mimari ve hiperparametre seçimlerine yardımcı olur. Test verisi ise geliştirme kararlarından bağımsız biçimde son performansı ölçer. Aynı örneklerin kümeler arasında sızması, gerçekte olduğundan yüksek başarı görünmesine yol açabilir.
Kayıp fonksiyonu ve optimizasyon nedir?
Kayıp fonksiyonu, model tahmini ile gerçek sonuç arasındaki farkı sayısal olarak ölçer. Optimizasyon algoritması bu kaybı azaltacak parametre güncellemelerini belirler. Sinir ağlarında hata bilgisi katmanlara geri taşınır ve ağırlıklar küçük adımlarla değiştirilir.
Overfitting nedir?
Aşırı öğrenme veya overfitting, modelin eğitim örneklerini çok iyi ezberleyip yeni veride başarısız olmasıdır. Daha çeşitli veri, düzenlileştirme, erken durdurma ve doğru doğrulama süreci bu riski azaltabilir. Amaç eğitim verisinde kusursuz sonuç değil, görülmemiş örneklere genellenebilen performanstır.
Büyük dil modelleri nasıl eğitilir?
Büyük dil modelleri, geniş metin koleksiyonlarında sonraki tokenı tahmin etme gibi görevlerle ön eğitilir. Daha sonra talimat örnekleriyle ince ayar ve insan tercihleriyle hizalama yapılabilir. Çok büyük bir modeli sıfırdan eğitmek yüksek veri, donanım ve enerji gerektirdiği için birçok uygulama hazır bir temel modeli kullanır.
Sıfırdan eğitim, ince ayar ve RAG farkı
Sıfırdan eğitim modelin tüm parametrelerini başlangıçtan öğrenir. Fine-tuning, önceden eğitilmiş modeli daha küçük bir veri setiyle belirli davranış veya göreve uyarlar. RAG ise model ağırlıklarını değiştirmeden, yanıt anında dış kaynaklardan bilgi getirir.
Model kalitesi nasıl değerlendirilir?
Doğruluk tek başına yeterli olmayabilir. Göreve göre precision, recall, F1, hata oranı, gecikme, maliyet, güvenlik, adalet ve kullanıcı memnuniyeti birlikte ölçülür. Üretken modellerde olgusal doğruluk, kaynakla uyum ve halüsinasyon oranı da değerlendirilmelidir.
Veri kalitesi ve sorumlu eğitim
Model, veride bulunan hataları ve dengesizlikleri öğrenebilir. Eğitim kümesinin hedef kullanıcıları ve gerçek kullanım koşullarını temsil etmesi gerekir. Etiketleme tutarlılığı, veri kaynağının izni, kişisel bilgilerin korunması ve az temsil edilen gruplardaki performans değerlendirilmelidir.
Veri seti, kod, model sürümü ve deney ayarlarının kayıt altına alınması sonuçların yeniden üretilebilmesini sağlar. Model kartları; amaç, bilinen sınırlamalar, uygun olmayan kullanım alanları ve test sonuçları hakkında şeffaflık sunabilir.
Model yayınlandıktan sonra süreç biter mi?
Hayır. Gerçek dünyadaki veri dağılımı zamanla değişebilir ve modelin performansı düşebilir. Buna veri veya kavram kayması denir. Üretimde hata oranı, gecikme, maliyet ve güvenlik sinyalleri izlenmeli; gerektiğinde güncel veriyle yeniden eğitim yapılmalıdır. Yeni sürüm doğrudan devreye alınmadan önce mevcut modelle karşılaştırılmalıdır.
Yapay zekâ modeli eğitimi hakkında sık sorulan sorular
Daha fazla veri her zaman daha iyi midir?
Hayır. Hatalı, tekrarlı veya temsil gücü düşük veri performansı bozabilir. Kalite ve çeşitlilik miktar kadar önemlidir.
Eğitim bittikten sonra model öğrenmeye devam eder mi?
Çoğu model çıkarım sırasında ağırlıklarını değiştirmez. Güncelleme için yeniden eğitim veya ince ayar gerekir.
Her şirket kendi modelini eğitmeli mi?
Çoğu durumda hazır bir modeli prompt, RAG veya ince ayarla uyarlamak daha hızlı ve ekonomiktir.
Sonuç
Yapay zekâ modeli eğitimi; veri hazırlama, optimizasyon, bağımsız değerlendirme ve üretim sonrası izlemeden oluşan sürekli bir yaşam döngüsüdür. Güvenilir sonuç için yalnızca model mimarisi değil, veri ve değerlendirme tasarımı da önemlidir.