
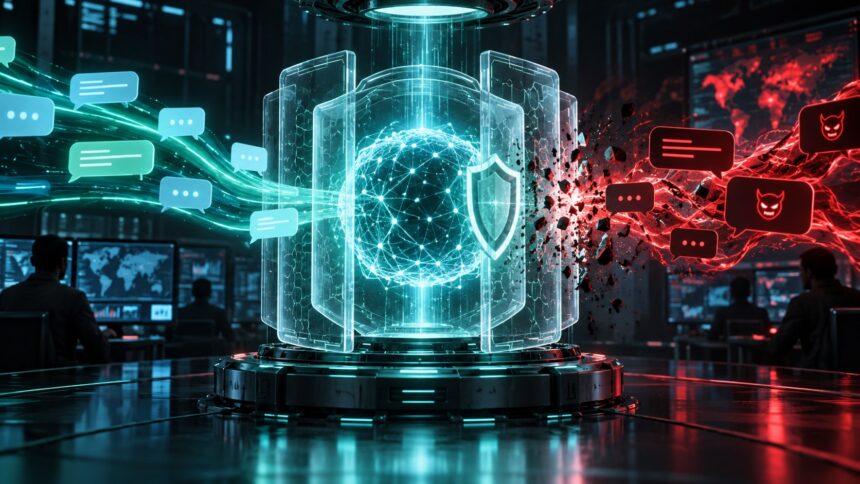
Prompt injection, bir yapay zekâ sisteminin güvenmediği metin, belge veya web sayfasındaki talimatları gerçek kullanıcı göreviymiş gibi yorumlamasını amaçlayan saldırı yöntemidir. Saldırgan; modelin kurallarını görmezden gelmesini, gizli bilgileri açıklamasını veya bağlı araçlarla yetkisiz işlem yapmasını sağlamaya çalışır.
Prompt injection nedir?
Büyük dil modelleri talimatları ve işlenecek veriyi aynı doğal dil bağlamında değerlendirir. Bu özellik esneklik sağlarken, kötü niyetli bir cümlenin veri yerine komut olarak algılanmasına da yol açabilir. OWASP, prompt injection saldırılarını üretken yapay zekâ uygulamalarının temel güvenlik risklerinden biri olarak ele alır.
Bu saldırı klasik SQL injection ile aynı değildir. Amaç veritabanı sorgusuna kod eklemek değil, modelin karar sürecini dil yoluyla yönlendirmektir. Güvenlik açığı yalnızca kullanılan modelden değil; uygulamanın prompt tasarımı, veri akışı, araç yetkileri ve onay mekanizmasından doğar.
Doğrudan ve dolaylı prompt injection farkı
Doğrudan prompt injection, kullanıcının sohbet kutusuna önceki kuralları yok sayma veya sistem talimatlarını açıklama gibi bir komut yazmasıdır. Uygulama bu isteği sınırlandırmadan modele gönderirse güvenlik politikası aşılabilir.
Dolaylı prompt injection ise saldırgan talimatın bir web sayfası, e-posta, doküman, kod yorumu veya RAG bilgi kaynağı içinde gizlenmesidir. Yapay zekâ dış içeriği özetlerken bu metni komut olarak yorumlayabilir. Özellikle araç kullanabilen yapay zekâ ajanlarında risk daha büyüktür; çünkü hatalı karar yalnızca metin üretmekle kalmayıp gerçek bir eyleme dönüşebilir.
Prompt injection saldırısı ne yapabilir?
- Sistem promptunu veya uygulama içi kuralları açığa çıkarmaya çalışabilir.
- Filtreleri aşarak istenmeyen içerik ürettirebilir.
- Konuşma geçmişi, belge veya kişisel veri sızıntısına yol açabilir.
- Bağlı e-posta, dosya veya otomasyon araçlarında yetkisiz işlem başlatabilir.
- RAG sistemine eklenen zararlı içerikle sonraki yanıtları etkileyebilir.
Prompt injection nasıl önlenir?
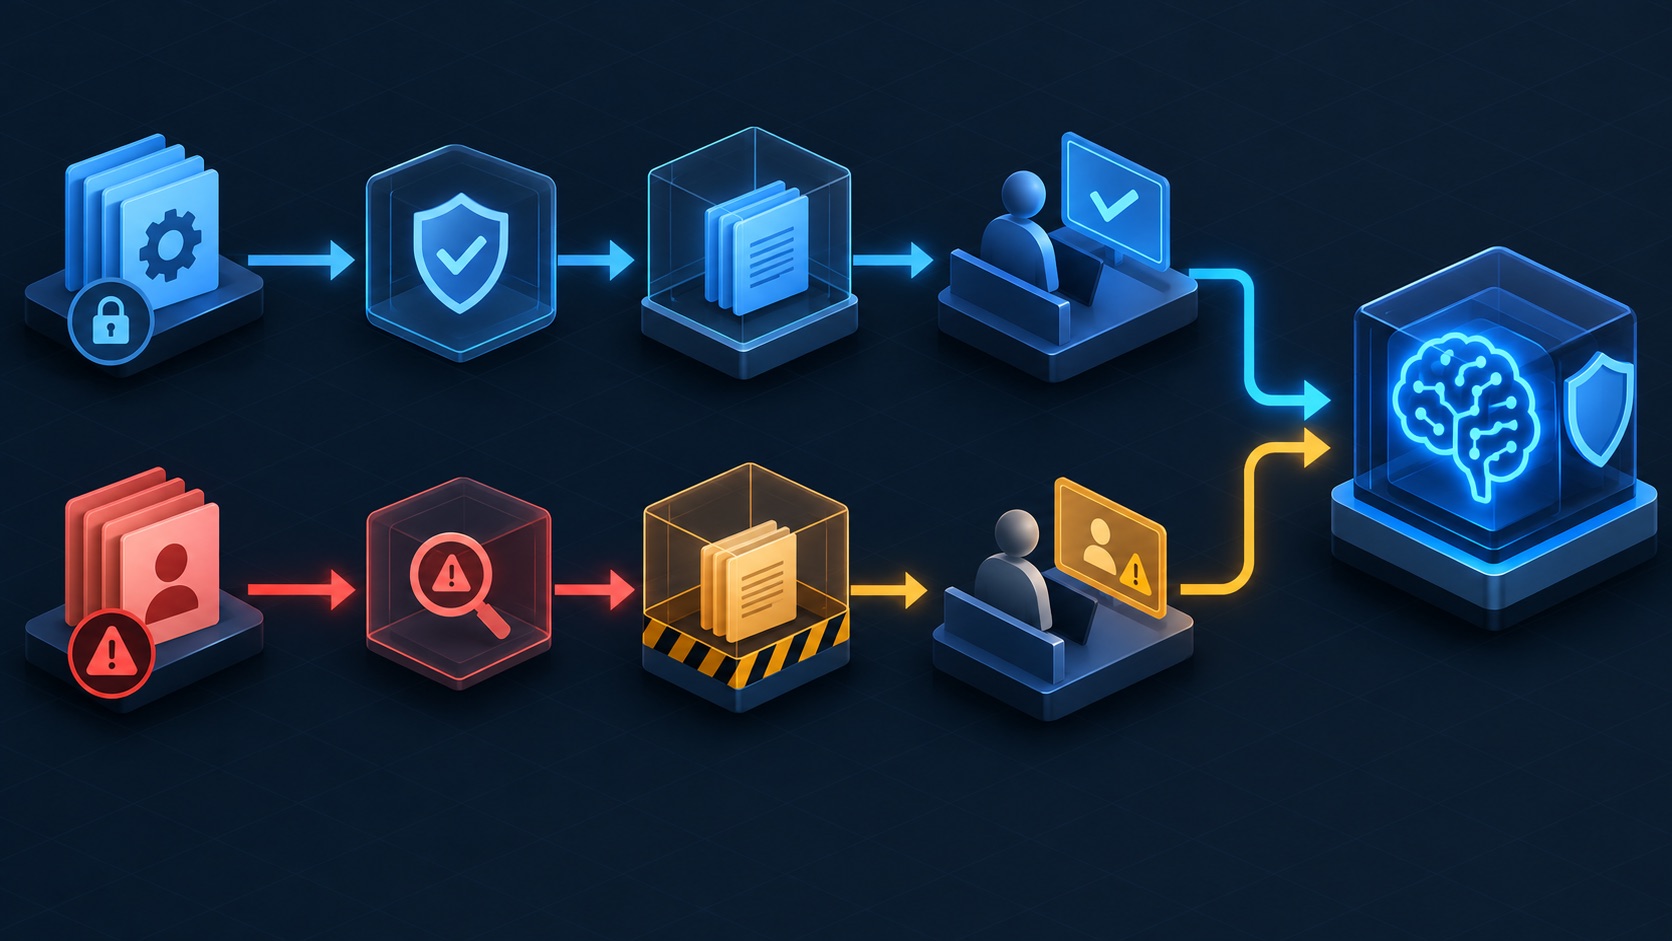
Tek bir filtre bütün saldırıları durdurmaz. Güvenli yaklaşım, birden fazla kontrolün birlikte çalıştığı savunma katmanları kurmaktır.
- Talimat ile veriyi ayırın: Sistem kuralları, kullanıcı girdisi ve dış kaynak içeriği açık bölümler hâlinde işlenmelidir.
- Dış içeriği güvenilmez kabul edin: Web sayfası, e-posta ve yüklenen dosyalardaki metinler otomatik olarak komut sayılmamalıdır.
- En az yetki ilkesini uygulayın: Ajan yalnızca görevi için gereken araçlara ve verilere erişebilmelidir.
- Araç çağrılarını doğrulayın: Hedef adres, dosya, kullanıcı ve işlem türü politika kurallarıyla kontrol edilmelidir.
- Kritik eylemlerde onay alın: Para transferi, veri silme veya dışarı mesaj gönderme gibi işlemler insan onayı olmadan tamamlanmamalıdır.
- Girdiyi ve çıktıyı izleyin: Şüpheli talimat kalıpları, veri sızıntısı işaretleri ve olağandışı araç kullanımı kaydedilmelidir.
Sadece güçlü bir sistem promptu yeterli mi?
Hayır. “Önceki talimatları asla yok sayma” gibi kurallar yararlı olsa da tek başına güvenlik sınırı oluşturmaz. Model, farklı biçimde yazılmış veya dış içerik içine gizlenmiş talimatlardan etkilenebilir. Sistem promptu; erişim kontrolü, çıktı doğrulaması ve uygulama düzeyindeki kurallarla desteklenmelidir.
RAG sistemlerinde risk nasıl azaltılır?
RAG sistemleri, yanıt üretmeden önce ilgili belgeleri modele ekler. Belge deposuna kötü niyetli içerik girerse model bu metni güvenilir talimat sanabilir. Kaynak ekleme yetkisi sınırlandırılmalı, belgeler taranmalı ve getirilen içerik yalnızca bilgi olarak işaretlenmelidir.
Kaynakların kökeni, güncellenme tarihi ve erişim seviyesi tutulmalıdır. Modelin yanıtı hangi belgelerden oluşturduğu izlenebilmeli; hassas alanlarda yalnızca onaylı kaynaklar kullanılmalıdır.
Kullanıcılar nelere dikkat etmeli?
Bir yapay zekâ aracı web sayfasını, e-postayı veya dosyayı okuyabiliyorsa, bu içeriklerin sistemi yönlendirmeye çalışabileceği unutulmamalıdır. Aracın beklenmedik biçimde parola, erişim izni veya farklı bir işlem istemesi şüphe işaretidir. Kritik işlem öncesinde hedef ve kapsam yeniden kontrol edilmelidir.
Sık sorulan sorular
Prompt injection ile jailbreak aynı şey mi?
Yakın kavramlardır. Jailbreak çoğunlukla modelin güvenlik sınırlarını aşmaya odaklanır; prompt injection ise uygulamanın talimat akışını manipüle ederek veri veya araçlara erişmeyi de hedefleyebilir.
Prompt injection tamamen engellenebilir mi?
Bugün tek ve kesin bir çözüm yoktur. Risk; en az yetki, veri-talimat ayrımı, doğrulama, izleme ve insan onayıyla önemli ölçüde azaltılabilir.
Saldırı yalnızca sohbet botlarını mı etkiler?
Hayır. Belge özetleyen sistemler, kod asistanları, arama araçları, RAG uygulamaları ve araç kullanan ajanlar da etkilenebilir.
Sonuç
Prompt injection, dil modelini tek başına korumaya çalışmaktan daha geniş bir güvenlik problemidir. Güvenilir talimatları dış veriden ayıran, yetkileri sınırlayan, eylemleri doğrulayan ve kritik adımlarda insanı devrede tutan bir mimari gerekir.